截面与面板数据分析 · 经济学专业本科生课程
双重差分法
Difference-in-Differences (DID) · 第一讲
两个维度 × 两次差分
政策效果,谁说了算?
先看三项我们国家自己的政策实践。点一点,看看你会先想到哪一个:
精准扶贫
脱贫攻坚重大决策
2020年全面消除绝对贫困
国家创新型城市试点
创新驱动发展战略
2008 年深圳先行,累计 78 个试点城市(区)
最低工资制度
保障低收入劳动者权益
各地标准多次调整
这些政策 有没有效?效果 有多大?
不靠印象和争论,靠科学的政策评估与 因果识别。
本课地图
为什么要学 DID
随机实验做不了、匹配也不够,看不见的因素造成选择性偏差
DID 的原理与检验
一张 2×2 均值表、DID 估计量,以及平行趋势假设怎么检验
用在真实研究里
最低工资:同一份数据的两种结论 · 创新型城市:政策前趋势检验 · 三种延伸做法
因果推断的方法地图:DID 在哪里?
因果推断
随机实验 (RCT)
匹配 (Matching)
双重差分 (DID)
断点回归 (RDD)
今天的主角:双重差分。 当实验做不了、匹配也控制不住"看不见"的因素时,就是它上场的时候。
上章回顾:两种方法,两个前提
随机对照实验
前提:随机化- 处理分配与个体特征完全无关
- 准实验若随机,可直接如实验数据分析
- 直接对比两组均值即可估计因果效应
匹配 (Matching)
前提:可观测选择- 给定可观测变量后可视为随机 (selection on observables)
- 用匹配为处理组找到可比的对照组
- 再做回归或均值差异对比
两个前提 这两个前提在现实中都很苛刻。随机化常常做不了,可观测变量也永远控制不完。
即使控制了可观测变量,处理组和对照组
仍可能存在系统差异,因为还有 不可观测因素。
Selection on Unobservables:不可观测因素同样造成选择性偏差
要校正它,我们需要一种新的识别思路:双重差分法 (DID)
课堂讨论:消费券,到底怎么评?
情境 某市为提振消费、帮扶中小微商户,计划发放消费券。请你来评估这项政策。先投一票:哪个方案能评出真实拉动效果?
市民报名,电脑随机摇号发放消费券
“满100减30”,自行申领、达标可用
方案A:摇号发放,两组可以直接对比
市民报名
电脑随机摇号发放
对比中签与未中签者的消费
随机摇号 → 能否中签,与个人的收入、年龄、消费习惯等因素无关
✓ 满足随机对照实验要求,直接对比两组均值即可
方案B:申领满减,谁去申领是自选的
申领和使用都由市民自己决定:有人抢着用,有人根本不领。谁会用券,是自我选择的结果。
市民的决策动机:可观测因素
- 收入与家庭财富
- 年龄与智能手机使用能力
- 住处离商圈的距离
→ 可用匹配解决 ✓
市民的决策动机:不可观测因素
- 消费习惯:节俭还是爱消费
- 对新活动的接受意愿
→ 匹配也无能为力 ✗
问题所在 不可观测因素同样造成选择性偏差,估计因果效应时必须处理它。匹配处理不了,这正是 DID 要解决的问题。
双重差分法:用两个维度识别因果
当可观测因素与不可观测因素同时造成选择性偏差时,双重差分法 (Difference-in-Differences, DID) 可以有效识别因果效应。
数据要求:两时点面板数据 ,即同一批个体在两个时点的信息
政策实施前(时点 0)
政策实施
政策实施后(时点 1)
DID 的直觉:一张 2×2 的均值表
行是处理组与对照组,列是政策前与政策后,四个格子里各放一个平均结果。
👈 点左边的按钮,
看两次差分如何把 β 一步步算出来
第一次差分:每组自己跟自己比
ΔYT = Y1T − Y0T
ΔYC = Y1C − Y0C
第二次差分:再减去对照组的变化
β̂DID = ΔYT − ΔYC = β
组内差分消去不随时间变化的不可观测因素;组间差分消去共同时间趋势,剩下的就是因果效应 β。
DID 估计量:从 2×2 表到回归方程
DID = E[Y1T − Y0T | T=1] − E[Y1C − Y0C | T=0]
上标 T / C 表示处理组 / 对照组,下标 1 / 0 表示政策处理后 / 处理前
实证中的回归实现:
Yit = α + ρ Ti + γ t + β Ti × t + εit
DID 的前提:平行趋势假设
假设内容
若处理组没有接受政策,其结果应与对照组具有相同的时间趋势。图上这条虚线与蓝线平行。
反事实的含义
我们无法同时观测同一个体的两种潜在结果。平行趋势让我们拿对照组,当作处理组“假如没接受政策”的样子。
这条虚线画得对不对,直接决定 β 估得准不准。下一页看它不成立会怎样。
按 → 也能推进这一步;图讲完后再按 → 才翻页。
什么是“平行趋势”?
如果处理组的样本没有接受政策处理,它们应当与对照组具有相同的时间趋势。
对照组是处理组的就是处理组的“反事实”,把它当作处理组未受政策时的潜在结果。
如果平行趋势不成立,DID 估计出的就不是政策的真实效应。
如果平行趋势不成立?
两组本来就有不同趋势时:
DID 估计 = 真实效应 β + 固有趋势差 δ
像图中这样会高估;如果处理组本来走得更弱,就会低估。
真实效应 β = 0.90 偏差 δ = 0.70 DID 估计 = 1.60
估计里混进了 0.70 的固有趋势差,这就是偏差。
所以必须先用政策发生之前的数据,检验这个 δ 是不是 0。这就是政策前趋势检验。
按 → 逐步作图;五步走完,再来拖上面的滑块。
换个角度:两个差分的分解
由回归式 Y = α + ρT + γt + β(T×t) + ε ,四个格子里的期望值分别是:
其中隐含两个差分: ① 政策前 vs 政策后(时间维度) ② 处理组 vs 对照组(组间维度)
为什么必须差分两次?
单差①:只看政策前后
E[D1] = E[Y1T] − E[Y0T]
= (α + ρ + γ + β) − (α + ρ) = γ + β
→ 消掉了 ρ,却混入共同的时间趋势 γ
单差②:只看组间差异
E[D2] = E[Y1T] − E[Y1C]
= (α + ρ + γ + β) − (α + γ) = ρ + β
→ 消掉了 γ,却混入两组的固有差异 ρ
DID = (E[Y1T] − E[Y0T]) − (E[Y1C] − E[Y0C]) = (γ + β)− γ = β
两次差分各消掉一种偏差:时间趋势 γ 被组间差分减掉,固有差异 ρ 被前后差分减掉,剩下的就是干净的 β。
按 → 一步一步做这两次减法;四步走完,再按 → 才翻页。
强假设,如何检验?
平行趋势是 DID 最重要的假设,而且是一个很强的假设
实证研究中,必须检验它,不能直接默认成立
理想的检验:让处理组“不接受处理”,再看它与对照组是否一致
现实中无法实施这种这种实验,历史不能重来一次
退而求其次:检验政策发生之前,两组是否具有相同的变化趋势
即“政策前趋势检验 (Pre-trend)”,需要足够长的时间跨度的数据
直觉:如果政策前两组趋势就明显不同,就很难相信政策后它们反而会平行。
案例①:最低工资提高了,就业降了吗?
1992 年 4 月,新泽西州把最低工资从 4.25 美元提到 5.05 美元(上调 18%),一河之隔的宾夕法尼亚州没有动。Card 与 Krueger 在政策前后各调查了一次两州的快餐店。
1992 年 2 月
1992 年 11 月
DID = (+0.59) − (−2.16) = +2.76 FTE / 店(标准误 1.36)
不降反升,而且统计上分得开零,与教科书预测正好相反。
先确认:政策真的落地了吗?
新泽西店的起薪 4.61 → 5.08 美元,按 4.25 美元起薪的店从 30.5% 掉到 0.0%;同期宾州起薪 4.63 → 4.62,仍有 25.3% 的店拿 4.25。处理确实只发生在一大组身上。
教科书怎么预测?
当时的综述结论是:最低工资提高 10%,青少年就业下降 1%~3%。按此外推,这次 18% 的上调应让每店减少 0.4~1.0 人。实测却是 +2.76。
那这段下降是什么?
宾州和州内那些本来就没受影响的店,同期就业也在往下走。作者把这归给 1992 年中大西洋各州经济持续变差。这就是 γ。
数据:Card & Krueger, Minimum Wages and Employment: A Case Study of the Fast Food Industry in New Jersey and Pennsylvania, NBER WP 4509 (1993),表 2、表 3。David Card 因实证劳动经济学贡献获 2021 年诺贝尔经济学奖。
同一份数据,为什么能吵三十年?
DID 的结论取决于两件事:你信哪个对照组,以及两组的政策前趋势差多少。这两件事,每一件都能改动那个 +2.76。
① 换一个对照组看看
宾夕法尼亚州(相邻、未上调)✓ 论文采用
点我看看这个选择好不好
新泽西州内高薪店(政策前已付 ≥5.00 美元)✓ 论文的第二个对照
点我看看这个选择好不好
全美平均✓ 省事
点我看看这个选择好不好
选完之后想一想:它凭什么能当对照组?
② 如果两州政策前趋势本来就不一样
DID 估计 = 真实效应 β + 固有趋势差 δ = +2.76
那么真实效应 β = +2.76 判定:仍与教科书相反
δ = 0 时,DID 就是真实效应:+2.76 人 / 店。
要把结论扳回教科书预测的 −0.4 ~ −1.0,需要 δ 达到 3.2 ~ 3.8,相当于每店 21 个员工的 15%~18%。而论文指出 1991—92 年新泽西失业率升得比宾州更多、经济更差,也就是说 δ 更可能是负的:那样 +2.76 反而是低估。
这场争论后来一直延续:Neumark 与 Wascher 认为必须把两州政策前已有的趋势差扣掉,扣完之后符号翻负。同一批数据,换一条反事实线,结论就跟着变。这就是第 15 页那个 δ 的真实版本,所以政策前趋势检验不能省。
案例②:创新型城市试点,激活创业了吗?
一项分批推进的改革
点上面任意一个节点,看这一步发生了什么。
研究设计:政策变量就是那个交互项
Entre_Activationit = α + β·(Group × Post)it + γ·Controlit + 城市FE + 年份FE + ε
2004—2018 年 280 个地级市,其中 71 个先后成为试点;被解释变量是每百人新创企业数,由企查查 1.3 亿余条企业微观记录匹配到城市。(式中的 γ 是控制变量系数,与前面讲的共同趋势 γ 不是一回事。)
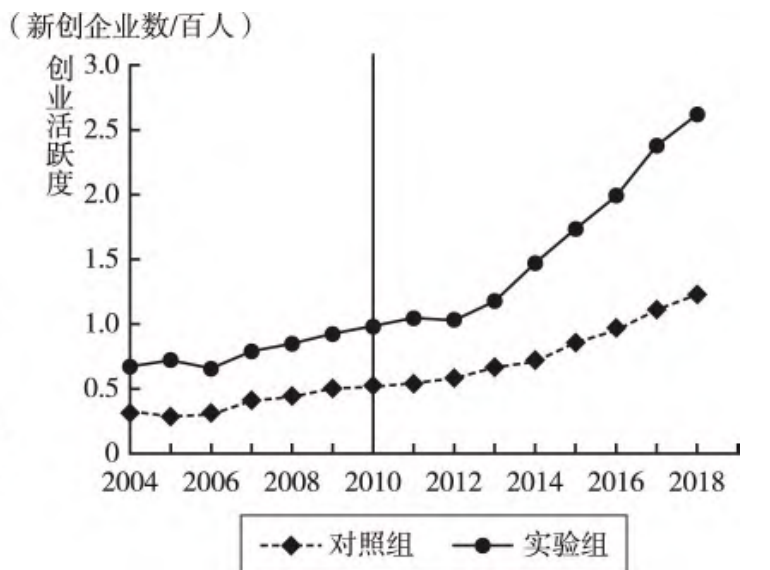
图 2 2010 年加入国家创新型城市试点的城市与非试点城市历年创业活跃度水平的变化(论文原图)
先看 2010 年之前:两条线走得差不多。论文原话是“二者具有较为一致的变化态势”。
政策背景与右图:白俊红、张艺璇、卞元超(2022),《中国工业经济》2022(6) 第 4 页图 1、图 2;样本与设计见第 6—7 页。
从深圳一城到 78 个试点城市(区),走的是"试点先行、积累经验、逐步推开":先干起来,再用证据评估,成熟了才推广。DID 正是"用证据评估"这一步的常用工具。
这个结论凭什么站得住?
① 同一份数据,四种设定,四个答案
设定与系数:白俊红等(2022)表 1、式(2)。
点一行,看这个设定把什么吸收了、什么还留在系数里。
基准那一列 0.2997:试点让每百人新创企业数增加约 0.30 家,量级上接近 2010 年对照组水平(约 0.5)的六成。而"什么都不加"的 1.07 约是这个基准值的 3.6 倍,城市之间本来就有的差异和全国创业一起上涨的趋势,都被算成了政策功劳。
② 政策前趋势检验:先问 δ 是不是 0
论文用相对时间虚拟变量逐项估计(式 2)。政策前各期系数都不显著、数值也小 → 两组政策前没有系统差异,δ ≈ 0。
示意图:按论文文字描述绘制(政策前各期不显著、数值小;3 期后显著为正)。横轴为相对本城市获批年的期数(式 2),真实系数图见《中国工业经济》网站原文附件。
稳健性:换用多时点 PSM—DID(截面匹配、逐期匹配两种做法),系数仍显著为正;效应集中在行政级别更高、区位更优的城市和非生产性服务业;机制是风险投资、人才、技术、政策四类集聚。
DID 的延伸:三种常用做法
PSM-DID
倾向得分匹配 + 双重差分
先用匹配为处理组筛选可比的对照组,再做标准 DID,让平行趋势更可信。
合成控制法
Synthetic Control
不找现成的对照组,人为加权“合成”一个虚拟对照:如 0.2安徽 + 0.5浙江 + 0.3湖北。
异时 DID · 事件研究
Event Study
政策逐年发生时,以发生年为第 0 期,统一对齐为 −2, −1, 0, +1, +2 … 估计动态效应。
小结与随堂练习
这节课讲了什么
随机实验做不了,匹配也管不了看不见的因素
两组各做前后差分,再相互一减,得到的 β 就是政策效果
两组趋势本来要平行;换对照组、扣掉政策前的趋势差之后结论还在,才算数
PSM-DID、合成控制法、事件研究三种扩展
✎ 动手设计一个政策评估
情境:家乡通了高铁。请评估“高铁开通是否提升了沿线商铺的营业额”。
请写出(点一下看提示):
从脱贫攻坚到创新驱动,中国的大规模政策实践,都需要科学的因果证据来检验与优化。
愿同学们以严谨求实的方法、用数据讲真话、以证据服务决策,
经世济民,学以致用。
课后思考:读白俊红等(2022)的图 2,用"政策前后 × 试点与否"画一张 2×2 示意,并说明这篇论文为什么必须用多时点 DID。